Il mondo dell’hardware tecnologico sta vivendo la sua più grande trasformazione dalla nascita di Internet. Al centro di questa rivoluzione ci sono chip straordinari come il recente NVIDIA H200, motori silenziosi che permettono a software come ChatGPT o i generatori di immagini di esistere. Ma come siamo arrivati a questo punto? E perché questi processori sono così fondamentali per l’intelligenza artificiale?
Una Breve Storia: Dai Videogiochi alla Conquista del Deep Learning
La storia delle GPU (Graphics Processing Units) non inizia nei laboratori di ricerca sull’IA, ma nelle camerette dei giocatori di videogame degli anni ’90.
- L’era della grafica 3D: Aziende come NVIDIA inventarono le GPU per un compito specifico: calcolare contemporaneamente la posizione e il colore di milioni di pixel per visualizzare videogiochi in tre dimensioni.
- La scoperta del 2012 (AlexNet): I ricercatori si accorsero che la matematica necessaria per la grafica 3D (le matrici) era identica a quella necessaria per le reti neurali. Nel 2012, una rete neurale chiamata AlexNet vinse una famosa competizione di visione artificiale venendo addestrata su normali GPU commerciali. Fu la svolta.
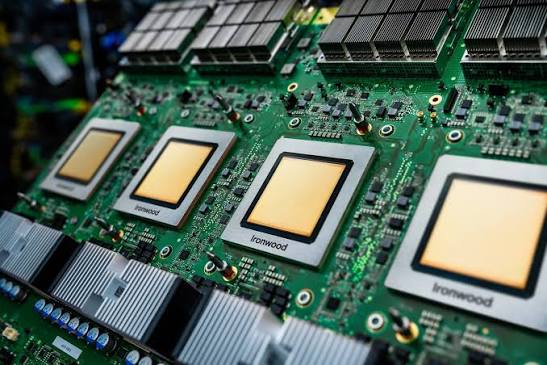
- La risposta di Google e la nascita delle TPU: Capendo che l’IA avrebbe richiesto una potenza immensa, nel 2015 Google creò le TPU (Tensor Processing Units). A differenza delle GPU, nate per la grafica e poi adattate, le TPU sono chip nati da un foglio bianco con un solo scopo: accelerare i calcoli dell’intelligenza artificiale.
Dal Chip H100 all’H200: Il Salto Generazionale di NVIDIA
Per capire lo stato dell’arte attuale, basta guardare l’evoluzione dei superchip di NVIDIA.
Il modello H100 (basato sull’architettura Hopper) è stato il re indiscusso del boom dell’IA tra il 2023 e il 2024. Tuttavia, i modelli linguistici (LLM) sono diventati così grandi da creare un “collo di bottiglia”: i chip passavano troppo tempo ad aspettare che i dati si spostassero dalla memoria al processore.
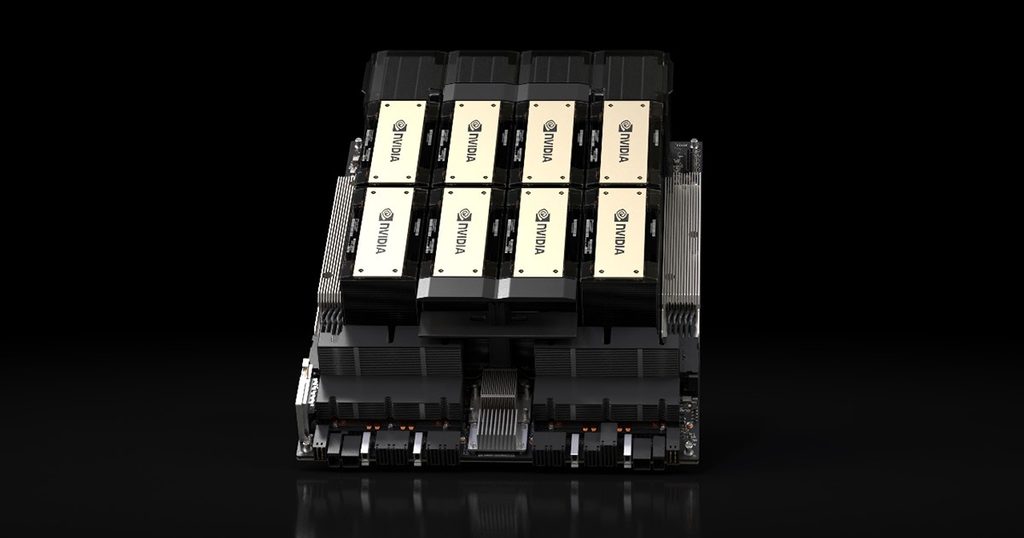
L’NVIDIA H200 risolve esattamente questo problema. Non cambia radicalmente la potenza di calcolo pura, ma introduce la memoria HBM3e (High Bandwidth Memory). Si tratta di una memoria ultra-veloce posizionata direttamente sopra il chip. Questo permette all’H200 di quasi raddoppiare la velocità con cui serve le risposte agli utenti, rendendo la gestione dei modelli giganti molto più fluida ed economica per le aziende.
Il Ruolo dei Chip nel “Training”: Costruire il Cervello Digitale
L’addestramento (o Training) è la fase in cui un’intelligenza artificiale “studia”. Immagina di dover far leggere a uno studente tutti i libri scritti dall’umanità per insegnargli a parlare.
- Calcolo parallelo massivo: Durante il training, il chip deve masticare miliardi di testi, immagini o video. Le GPU eccellono qui perché contengono migliaia di piccoli nuclei (core) che lavorano in contemporanea.
- Lavoro di squadra (Cluster): Un singolo chip non basta. Per addestrare i modelli moderni si collegano tra loro decine di migliaia di H200 o TPU in enormi data center. La velocità di comunicazione tra questi chip è vitale tanto quanto la potenza del singolo processore.
- Il consumo energetico: Il training è la fase più costosa e pesante. Richiede settimane o mesi di calcoli ininterrotti e consuma enormi quantità di energia elettrica.
Il Ruolo dei Chip nell’ “Inferenza”: L’IA Risponde in Tempo Reale
Una volta che il modello è addestrato, viene pubblicato. Quando un utente scrive un prompt in una chat e riceve una risposta, si attiva la fase di Inferenza (Inference). Il modello “inferisce” la risposta corretta usando ciò che ha studiato.
- Questione di millisecondi: Se nel training conta la potenza bruta, nell’inferenza conta la latenza (la velocità di risposta). Gli utenti non vogliono aspettare secondi per ogni singola parola generata.
- Ottimizzazione dei costi: L’inferenza avviene miliardi di volte al giorno in tutto il mondo. Chip come l’H200 o le TPU di Google sono progettati per eseguire questa fase consumando la minor quantità di energia possibile per singola richiesta.
- Il vantaggio dell’H200: Grazie alla sua enorme larghezza di banda della memoria, l’H200 eccelle nell’inferenza dei modelli più moderni, riuscendo a gestire molti più utenti contemporaneamente rispetto alla generazione precedente.
GPU contro TPU: Chi Sta Vincendo la Partita?
Oggi il mercato è diviso da due filosofie hardware differenti:
- NVIDIA (Flessibilità e Dominio): Le sue GPU (H100, H200, Blackwell) sono lo standard del settore. Chiunque può acquistarle (se ha il budget) e funzionano con qualsiasi software grazie a CUDA, la piattaforma di programmazione proprietaria di NVIDIA che gli sviluppatori usano da oltre 15 anni.
- Google TPU (Efficienza e Cloud): Le TPU sono chip verticali ed estremamente efficienti. Google non le vende fisicamente ad altre aziende; le mette a disposizione tramite la sua piattaforma Cloud (Google Cloud Platform). Sono perfette per chi lavora con il framework TensorFlow o JAX e vuole ottimizzare i costi su larga scala.
L’hardware per l’IA non è più un semplice componente del computer: è la nuova risorsa geopolitica ed economica più contesa del pianeta.
Prezzi di riferimento
Quanto costa comprare una GPU NVIDIA?
Le schede grafiche di punta non si trovano nei normali negozi e i listini ufficiali B2B sono spesso riservati, ma i prezzi reali di mercato (street price) sono definiti.
Costa tra i 25.000 e i 31.000 per singola scheda. [1, 2]
Il prezzo sale tra i 30.000 e i 40.000 a chip, a causa della memoria ultra-veloce HBM3e che incide pesantemente sulla produzione. [1, 2]