Quando un Large Language Model genera una frase, non si limita a leggere le parole una dopo l’altra: deve stabilire quali elementi del testo siano più importanti per interpretare correttamente ciò che sta leggendo. È proprio qui che entra in gioco il blocco Attention, uno dei componenti fondamentali dell’architettura Transformer e, di conseguenza, dei moderni LLM. L’Attention permette al modello di mettere in relazione tra loro le diverse parole di una sequenza, assegnando maggiore peso a quelle che risultano più rilevanti per comprendere o generare il token successivo.
L’intelligenza del modello non sta soltanto nelle parole che conosce, ma nelle relazioni che riesce a costruire tra di esse.
Dalle parole alle relazioni
Per capire il funzionamento dell’Attention, immaginiamo la frase: “Il gatto si è nascosto perché aveva paura del cane.” Per interpretare correttamente il significato di “aveva”, il modello deve stabilire a quale elemento della frase quel verbo si riferisca. Non tutte le parole hanno la stessa importanza: “gatto” e “cane”, per esempio, possono essere molto più rilevanti di parole come “il” o “perché”.
Il blocco Attention svolge proprio questo lavoro. Ogni token viene trasformato in una rappresentazione numerica e, attraverso tre componenti chiamate Query, Key e Value, il modello calcola quali altri token siano maggiormente rilevanti rispetto a quello che sta elaborando.
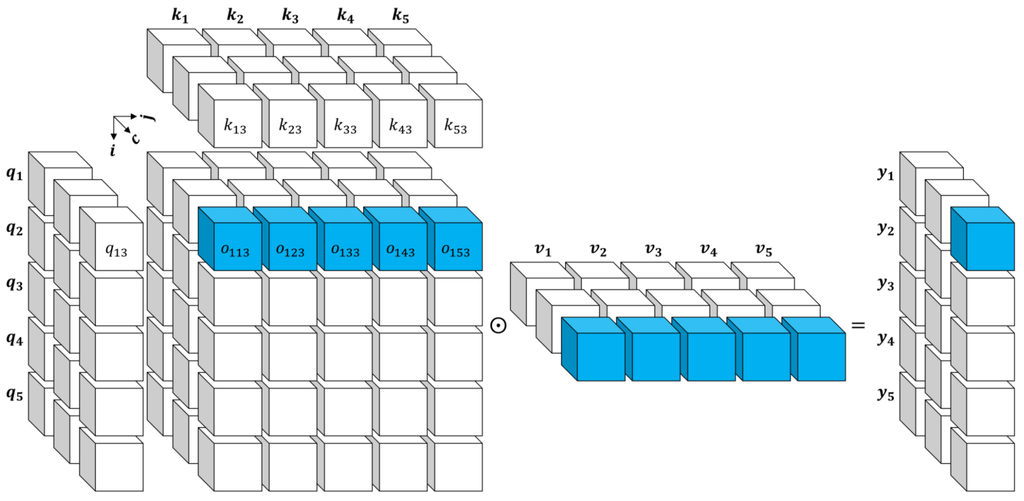
La Query può essere vista come una domanda: “Quali informazioni mi servono in questo momento?”. La Key rappresenta invece una sorta di etichetta che permette di confrontare le diverse informazioni disponibili, mentre il Value contiene l’informazione che verrà effettivamente utilizzata. Attraverso il confronto tra Query e Key, il modello produce dei pesi di attenzione e li utilizza per combinare i diversi Value.
In termini semplificati, il processo può essere rappresentato dalla formula:
Attention(Q, K, V) = softmax(QKᵀ / √dₖ)V
Il prodotto tra Q e Kᵀ misura quanto ogni elemento sia rilevante rispetto agli altri. La divisione per √dₖ serve a mantenere i valori in un intervallo numericamente gestibile, mentre la funzione softmax trasforma i punteggi in pesi che possono essere interpretati come una distribuzione dell’attenzione. Infine, questi pesi vengono utilizzati per creare una combinazione ponderata dei Value.
Perché l’Attention è così importante
La vera forza dell’Attention emerge quando il testo diventa più lungo e complesso. In un modello tradizionale, mantenere le relazioni tra elementi lontani nella sequenza può essere difficile. L’architettura Transformer, invece, permette di confrontare direttamente i token tra loro.
Questo non significa che il modello “comprenda” il testo nello stesso modo in cui lo comprende una persona. L’Attention è un meccanismo matematico che consente al modello di costruire rappresentazioni contestuali. La rappresentazione di una parola, quindi, può cambiare in funzione delle parole che la circondano.
Un altro elemento fondamentale è la Multi-Head Attention. Invece di calcolare una singola attenzione, il modello utilizza più “teste” che possono concentrarsi su aspetti differenti della sequenza. Una testa potrebbe catturare una relazione sintattica, un’altra una relazione semantica e un’altra ancora una dipendenza tra elementi molto distanti. Le informazioni ottenute vengono poi combinate per produrre una rappresentazione più ricca.
Questa capacità di osservare il testo attraverso prospettive diverse è una delle ragioni per cui i Transformer riescono a gestire efficacemente compiti linguistici molto complessi.
Dall’Attention alla generazione del testo
Negli LLM autoregressivi, come quelli utilizzati per la generazione del linguaggio, l’Attention deve inoltre rispettare una regola fondamentale: il modello non può utilizzare informazioni provenienti dal futuro. Per questo viene impiegata la causal attention, nella quale ogni token può prestare attenzione soltanto ai token precedenti e a sé stesso.
Quando il modello deve generare una nuova parola, utilizza quindi il contesto disponibile per calcolare una distribuzione di probabilità sui possibili token successivi. L’Attention contribuisce a costruire quel contesto, permettendo al modello di stabilire quali informazioni siano più utili in quel preciso momento.
È importante sottolineare che l’Attention non è l’unico componente del Transformer. Ogni blocco contiene anche altri elementi, tra cui feed-forward network, residual connection e layer normalization. L’insieme di questi componenti viene ripetuto numerose volte e permette di trasformare progressivamente le rappresentazioni dei token.
Conclusione con approfondimenti chiave
Il blocco Attention può quindi essere considerato come uno dei meccanismi centrali attraverso cui un LLM costruisce il contesto necessario per elaborare il linguaggio. Attraverso Query, Key e Value, il modello determina quali informazioni siano maggiormente rilevanti; con la Multi-Head Attention può analizzare contemporaneamente diversi tipi di relazione; con la causal attention può invece generare testo mantenendo il vincolo di non “guardare” ai token futuri.
La cosa più interessante è che l’Attention non dice esplicitamente al modello che cosa significhi una parola: gli permette piuttosto di calcolare quali relazioni tra le parole siano utili in quel momento. È proprio da questa rete dinamica di relazioni che emerge gran parte della capacità dei moderni LLM di elaborare e generare linguaggio.
Comprendere l’Attention significa quindi comprendere uno dei passaggi fondamentali che trasformano una semplice sequenza di token in una rappresentazione contestuale, sulla quale il modello può costruire la sua risposta.