L’AI sta cambiando radicalmente il modo in cui scriviamo software. Oggi possiamo descrivere un problema in linguaggio naturale e ottenere in pochi secondi centinaia, se non migliaia, di righe di codice funzionante. Questa capacità è straordinaria, ma porta con sé un paradosso: più diventa facile generare codice, più diventa importante saperlo leggere, comprenderlo e giudicarlo. Nell’era dell’AI, quindi, mantenere una relazione quotidiana con il codice non è un esercizio nostalgico da programmatori di una generazione precedente. È una forma di autonomia.
L’AI può scrivere molto più codice di noi. Ma dobbiamo ancora essere noi a decidere quale codice merita di essere scritto.
Il problema non è usare l’AI, ma smettere di saperne fare a meno
Delegare parte del lavoro all’AI è ormai una scelta naturale. Generare boilerplate, scrivere test, esplorare un’API, trasformare un algoritmo da un linguaggio a un altro o produrre rapidamente una prima implementazione sono attività in cui un assistente AI può aumentare enormemente la produttività.
Il problema nasce quando la delega diventa dipendenza.
In architettura software, il coupling descrive quanto due componenti siano legati tra loro. Un’eccessiva dipendenza rende un sistema più difficile da modificare, sostituire o comprendere. Possiamo utilizzare una metafora simile anche nel rapporto tra sviluppatore e AI: se la nostra capacità di costruire, correggere e comprendere software dipende completamente dalla presenza di un modello, abbiamo creato una forma di accoppiamento che può diventare pericolosa.
Il punto non è evitare questo strumento, ma evitare che diventi una scatola nera indispensabile.
Uno sviluppatore dovrebbe poter utilizzare l’AI perché è il modo più efficiente di lavorare, non perché senza di essa non sa più da dove cominciare.
I fondamentali non diventano obsoleti
Per questo motivo continuare a esercitarsi sulle fondamenta della programmazione è forse ancora più importante di prima.
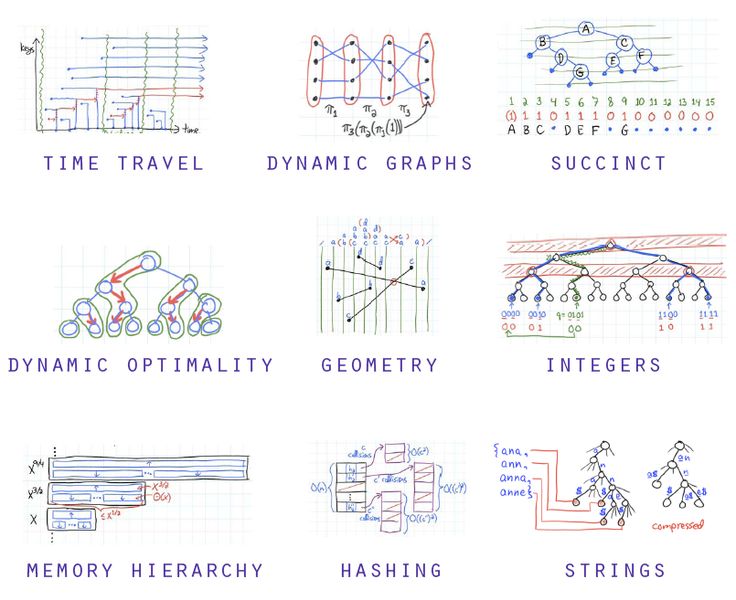
Strutture dati come Linked List, Stack, Queue, Hash Table e Cache non sono semplicemente esercizi da colloquio tecnico. Sono mattoni concettuali che permettono di comprendere come vengono organizzate e manipolate le informazioni all’interno di un programma.
Lo stesso vale per gli algoritmi.
Sapere come funziona una binary search, saper invertire una linked list, comprendere una hash table, riconoscere la differenza tra una ricerca lineare e una ricerca dicotomica o ragionare sulla complessità temporale di un algoritmo significa costruire un modello mentale del software.
E questo modello mentale diventa ancora più prezioso quando il codice viene generato da un modello linguistico.
Se l’AI produce cinquanta righe di codice che implementano una struttura dati, possiamo limitarci a copiarle. Oppure possiamo guardarle e chiederci: perché è stata scelta questa struttura? Qual è la complessità di questa operazione? Cosa succede nel caso limite? Dove viene allocata la memoria? Quali invarianti devono essere mantenute?
Nel secondo caso l’AI diventa un moltiplicatore delle nostre capacità, non un sostituto della nostra capacità di ragionare.
La generazione di codice diventerà sempre più economica
C’è un aspetto dell’evoluzione dell’AI che vale la pena considerare: il costo della generazione del codice sta diminuendo rapidamente.
Un tempo scrivere cento righe di codice richiedeva cento righe di digitazione e, soprattutto, una certa quantità di tempo. Oggi possiamo descrivere il comportamento desiderato e lasciare che un modello produca una prima implementazione.
Questo cambia completamente il collo di bottiglia.
Se generare codice diventa sempre più economico, il valore dello sviluppatore si sposta progressivamente dalla produzione manuale alla capacità di specificare, verificare, decomporre e valutare.
E qui emerge un problema interessante: per verificare correttamente un pezzo di codice generato, dobbiamo avere abbastanza conoscenze da capire se quel codice abbia senso.
Non basta chiedere all’AI: “Questo codice è corretto?”
Bisogna essere in grado di formulare domande migliori:
Qual è la complessità?
Quali sono i casi limite?
Questa cache può avere problemi di consistenza?
Questa struttura dati è appropriata?
L’algoritmo scala quando l’input cresce?
Questa implementazione introduce una race condition?
Perché qui è stato utilizzato uno Stack invece di una Queue?
La qualità della risposta dipende spesso dalla qualità del problema che siamo in grado di porre.
Conoscere i mattoni significa dominare la generazione chilometrica di codice
Se ci dovessimo trovare davanti a un’applicazione generata in gran parte dall’AI. Il codice potrebbe essere lungo migliaia di righe, distribuito tra decine di file, librerie e servizi.
In questa situazione non è realistico controllare manualmente ogni singola riga.
Quello che serve è riconoscere rapidamente i pattern fondamentali.
Una Linked List.
Una cache con una determinata strategia di eviction.
Uno Stack utilizzato per gestire una struttura LIFO.
Una Hash Map.
Un algoritmo di ricerca.
Un grafo.
Una coda di messaggi.
Una struttura ad albero.
Un algoritmo ricorsivo.
Una pipeline di trasformazione dei dati.
Più dominiamo questi mattoni, più velocemente possiamo orientarci all’interno di una quantità enorme di codice.
È una differenza fondamentale: non dobbiamo necessariamente scrivere ogni riga, ma dobbiamo essere capaci di dominare cosa sta succedendo.
L’AI può produrre chilometri di codice. La competenza tecnica ci permette di attraversarli senza perderci.
Anche sperimentare con i linguaggi continua a essere fondamentale
Per lo stesso motivo, è importante continuare a programmare direttamente e sperimentare con linguaggi diversi.
Non necessariamente per diventare esperti di ogni linguaggio, ma perché ogni linguaggio costringe a confrontarsi con un diverso insieme di astrazioni.
Programmare in C può rendere più evidente il rapporto tra memoria e dati. Un linguaggio funzionale può portare a ragionare diversamente su immutabilità e composizione. Rust introduce una prospettiva particolarmente interessante sulla gestione della memoria e sulla sicurezza. Python permette di esplorare rapidamente idee e prototipi. Java, Go, C++, JavaScript e molti altri linguaggi presentano modelli, trade-off e filosofie differenti.
L’atto di programmare senza delegare immediatamente tutto all’AI mantiene allenata una competenza fondamentale: trasformare un’idea in una struttura computazionale.
E questa competenza non scompare perché abbiamo a disposizione un modello linguistico.
Al contrario, diventa il nostro principale strumento per utilizzarlo bene.
La vera skill dell’era AI è il controllo
Forse il cambiamento più importante non consiste nel passare da “scrivere codice” a “non scrivere più codice”.
Consiste nel passare da scrivere tutto manualmente a controllare un sistema capace di generare enormi quantità di codice.
È una differenza sostanziale.
Un programmatore che conosce bene algoritmi, strutture dati, sistemi operativi, networking, database e architettura software può utilizzare l’AI per accelerare il proprio lavoro. Un programmatore che ha completamente delegato questi fondamentali rischia invece di trovarsi nella situazione opposta: produrre molto più codice, ma comprenderne sempre meno.
E quando qualcosa si rompe, la differenza diventa evidente.
Finché tutto funziona, generare codice è facile. Quando arriva un bug difficile, un problema di performance, un deadlock, una race condition o un comportamento inatteso in produzione, torna a essere indispensabile la capacità di ragionare sul sistema.
Conclusione: non dobbiamo programmare meno, dobbiamo programmare meglio
L’AI non rende inutili i fondamentali della programmazione. Li rende più importanti.
Continuare a implementare una Linked List, scrivere una binary search, invertire una linked list, costruire una cache, implementare uno Stack o affrontare un problema algoritmico può sembrare anacronistico in un mondo nel quale possiamo semplicemente chiedere a un modello di farlo per noi.
In realtà è esattamente il contrario.
Questi esercizi costruiscono la grammatica mentale necessaria per comprendere il software generato dall’AI. Ci permettono di distinguere una buona soluzione da una soluzione soltanto plausibile, di riconoscere un’astrazione sbagliata, di individuare un collo di bottiglia e, soprattutto, di sapere quando non fidarci della risposta del modello.
Il futuro probabilmente non sarà caratterizzato da sviluppatori che scrivono ogni riga a mano. Sarà caratterizzato da sviluppatori capaci di orchestrare la generazione di quantità enormi di software mantenendo il controllo sull’architettura, sugli algoritmi e sulle conseguenze delle proprie scelte.
Per questo vale la pena continuare a stare vicini al codice.
Non per competere con l’AI nella velocità con cui scrive una funzione.
Ma per essere abbastanza competenti da poterle dire cosa costruire, perché costruirlo e come capire se lo ha costruito bene.