Oltre la Tabella: Guida Tecnica a OLAP, OLTP e l’Anatomia dei Cubi Multidimensionali

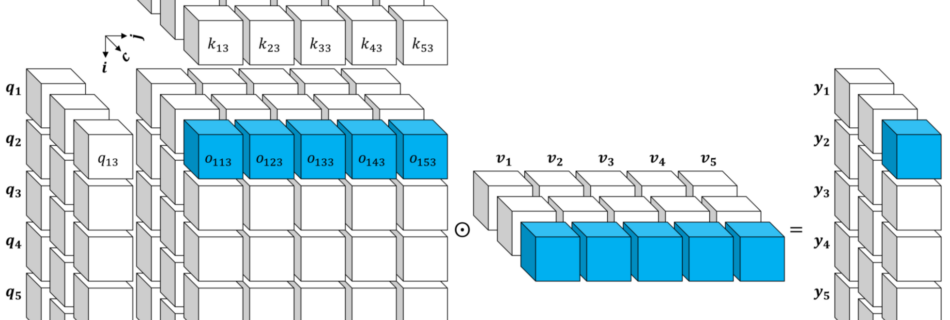
Nel mondo della gestione dei dati esiste una linea di demarcazione netta che separa due necessità fondamentali: la scrittura ultra-rapida dei dati e la loro lettura analitica su scala massiva. Questa separazione si riflette in due paradigmi architetturali: OLTP (Online Transaction Processing) e OLAP (Online Analytical Processing).  Se per un database OLTP la tabella normalizzata …

Oltre la Linea Rossa: il rischio sistemico a quota 10^25 FLOP e il paradosso della Silicon Valley

Per i leader d’azienda, la gestione del rischio si misura solitamente in fluttuazioni di mercato, barriere all’entrata o svalutazioni degli asset. Oggi, tuttavia, la metrica più critica per la conformità legale e la continuità aziendale globale si riassume in un’espressione puramente matematica: 102510^{25} FLOP. Questo numero rappresenta lo spartiacque ufficiale tra l’innovazione ordinaria e la …

Oltre la Privacy: La FRIA come Pilastro della AI Governance e l’Impatto dell’Articolo 27 dell’AI Act

L’era della pura conformità tecnica e della tutela circoscritta ai dati personali sta cedendo il passo a una visione olistica della responsabilità algoritmica. Con la progressiva entrata in vigore delle scadenze europee, l’attenzione della governance aziendale si sta spostando su uno strumento rimasto a lungo nell’ombra rispetto alla nota DPIA (valutazione d’impatto sulla protezione dei …

Guida Definitiva all’AI Act: Come l’Europa sta Ridisegnando il Futuro dell’Intelligenza Artificiale

L’Intelligenza Artificiale non è più una promessa del futuro, ma il motore del nostro presente. Dai generatori di immagini ai sistemi predittivi aziendali, gli algoritmi plasmano le nostre decisioni quotidiane. In questo scenario da “Far West” tecnologico, l’Unione Europea ha tracciato una linea nella sabbia. L’AI Act è ufficialmente il primo regolamento sistematico al mondo …

Oltre il Next-Token Prediction: Come RLVR e GRPO Insegnano il Ragionamento Logico agli LLM

Nel ciclo di vita di un Large Language Model (LLM), il pretraining rappresenta solo il primo passo. Durante questa fase iniziale, il modello apprende unicamente a prevedere il token successivo all’interno di un testo, basandosi sulla distribuzione di probabilità calcolata su un corpus di dati gigantesco. Questo processo fornisce al modello una straordinaria conoscenza enciclopedica …

Perché le Intelligenze Artificiali si addestrano misurando la “Sorpresa”: Viaggio nella Cross-Entropy Loss

Immagina di guardare il cielo in una tipica giornata d’estate e di sentirti dire: “Domani ci sarà il sole”. Quanta nuova informazione hai ricevuto? Praticamente zero. Ma se qualcuno ti dicesse: “Domani nevicherà”, la tua reazione sarebbe di totale sorpresa. Questo concetto così umano – la sorpresa – è lo stesso motore invisibile che usiamo …

Come funziona l’autograd di PyTorch: dentro i grafi delle derivate – P1

Quando si inizia a lavorare con PyTorch, una delle righe più misteriose è spesso questa: Sembra quasi una magia. Abbiamo calcolato una loss, chiamiamo backward(), e improvvisamente PyTorch sa come modificare milioni o miliardi di parametri del modello. Ma cosa succede davvero? La risposta è: PyTorch costruisce e attraversa un grafo di operazioni matematiche per …

Probabilità e verosimiglianza:

qual è la differenza e perché è importante negli LLM? Capire questa distinzione è importante perché permette di comprendere meglio come un LLM genera testo e, soprattutto, come viene addestrato. 1. Probabilità: “quanto è probabile che accada?” Partiamo dalla probabilità. La probabilità risponde, in generale, a una domanda di questo tipo: Dato un certo modello, …

Dalla chat all’agente: cosa sono Harness e MCP Server?

Un LLM, preso da solo, è soprattutto un motore capace di elaborare testo e generare risposte. Ma un sistema AI realmente utile deve fare molto di più: deve poter utilizzare strumenti, accedere a dati, mantenere un contesto operativo, eseguire azioni e interagire con sistemi esterni. È qui che entrano in gioco due concetti sempre più …

Il meccanismo che permette agli LLM di “capire” il contesto

Quando un Large Language Model genera una frase, non si limita a leggere le parole una dopo l’altra: deve stabilire quali elementi del testo siano più importanti per interpretare correttamente ciò che sta leggendo. È proprio qui che entra in gioco il blocco Attention, uno dei componenti fondamentali dell’architettura Transformer e, di conseguenza, dei moderni …