Quando parliamo di Cloud Computing siamo abituati a immaginare un modello abbastanza semplice:
Device / Sensor -> Internet -> Cloud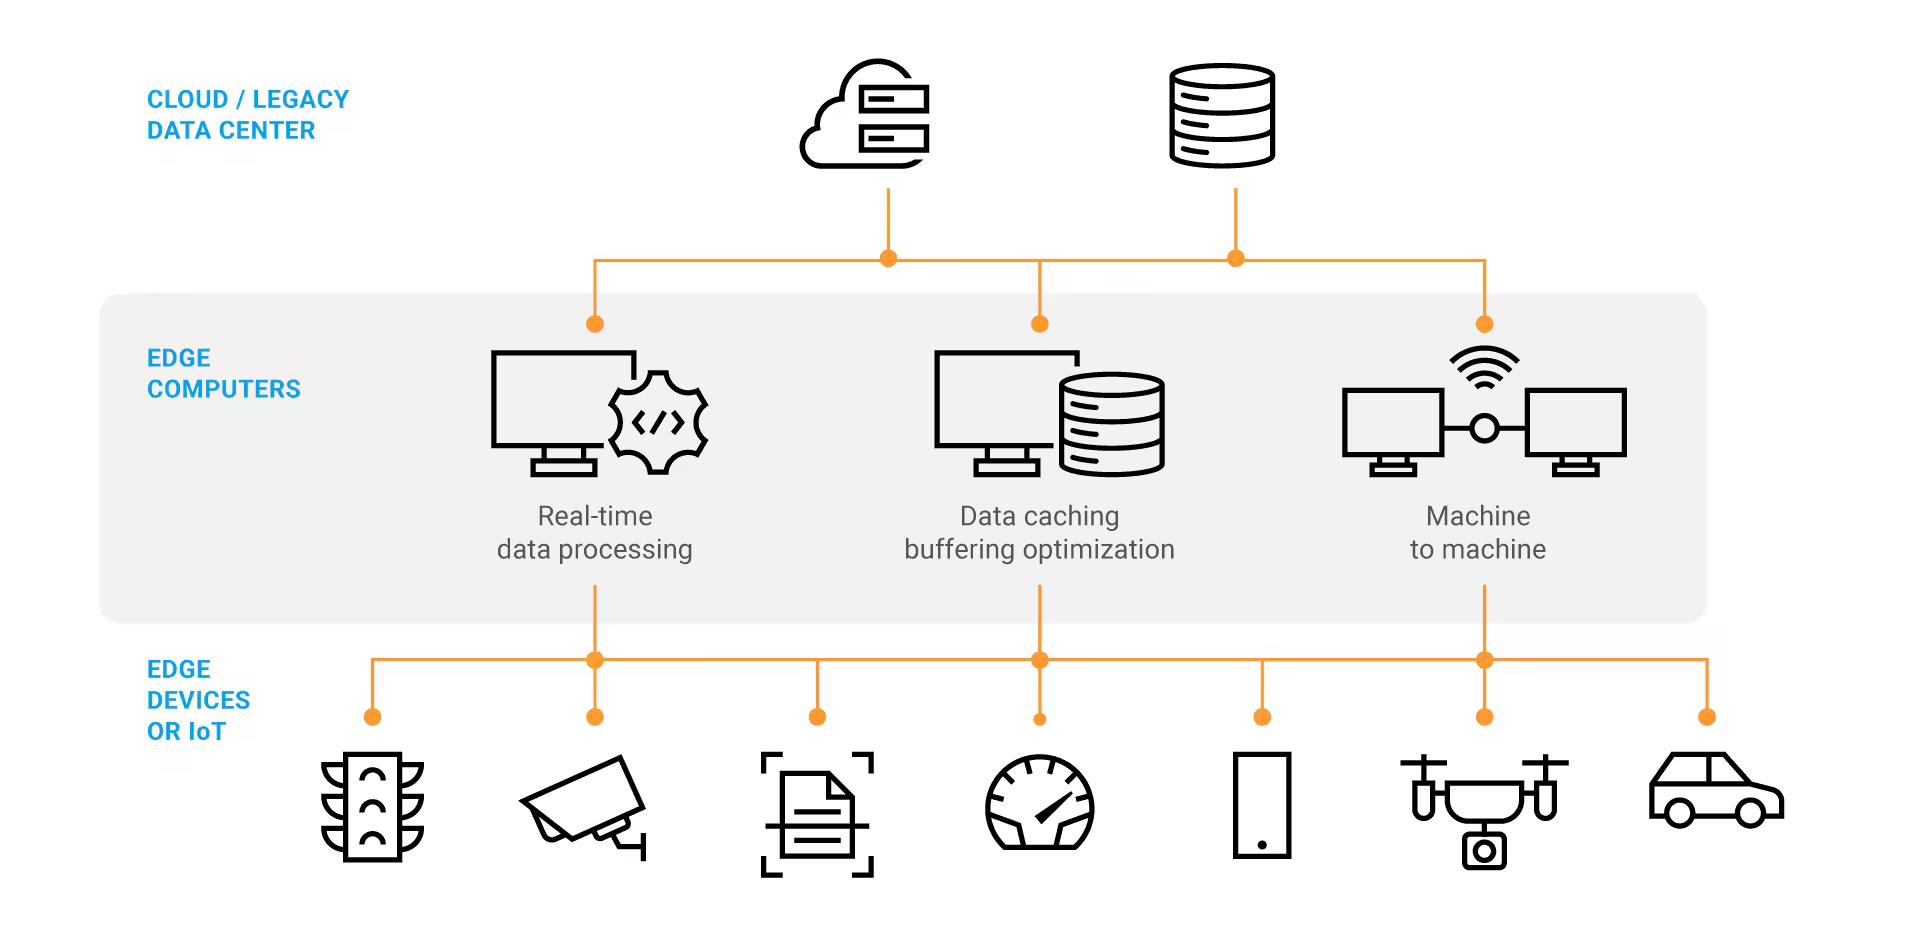
Il dispositivo raccoglie dati, li invia al cloud e il cloud li elabora.
Ma cosa succede quando abbiamo miliardi di dispositivi, enormi quantità di dati e applicazioni che devono prendere decisioni in pochi millisecondi?
Qui entra in gioco l’Edge Computing.
Cos’è l’Edge Computing?
L’idea fondamentale è semplice:
portare parte dell’elaborazione il più vicino possibile alla sorgente dei dati.
Invece di:
Sensor → Internet → Cloud → elaborazionepossiamo avere:
Sensor
   |
   v
Edge Gateway / Edge Server
   |
   +----> decisione locale
   |
   +----> dati aggregati
   |
   v
 Cloud
L’edge non elimina quindi il cloud.
Piuttosto, crea un’architettura distribuita nella quale alcune elaborazioni vengono eseguite vicino al dispositivo mentre altre continuano a essere eseguite centralmente.
Perché utilizzare l’Edge?
Ci sono almeno quattro motivazioni fondamentali.
1. Latenza
Se una macchina industriale deve reagire in pochi millisecondi, non è necessariamente conveniente:
sensore
   ↓
rete
   ↓
cloud
   ↓
elaborazione
   ↓
rete
   ↓
macchina
Possiamo invece elaborare localmente:
sensore
   ↓
edge
   ↓
decisione
   ↓
macchina
La riduzione della latenza può essere fondamentale in ambiti come robotica, veicoli autonomi, controllo industriale e applicazioni real-time.
2. Bandwidth
Immaginiamo migliaia di telecamere.
Mandare continuamente tutto il video al cloud può essere estremamente costoso.
Un edge server potrebbe invece effettuare localmente una prima elaborazione:
Camera
   |
   v
Edge AI
   |
   +---- "nessun evento"
   |
   +---- "persona rilevata"
   |
   +---- "anomalia rilevata"
   |
   v
Cloud
Il cloud potrebbe ricevere soltanto gli eventi o i dati aggregati.
3. Resilienza
Un dispositivo edge può continuare a eseguire alcune funzioni anche quando la connessione verso il cloud è degradata o temporaneamente assente.
Questo è particolarmente importante nell’IoT industriale.
4. Privacy
Non tutti i dati devono necessariamente lasciare il luogo in cui vengono generati.
Possiamo elaborare localmente informazioni sensibili e inviare al cloud soltanto il risultato necessario.
Ma cosa c’è dentro un Edge Node?
Un edge node può essere molto diverso a seconda dello scenario.
Può essere:
- un piccolo gateway IoT;
- un industrial PC;
- un server installato in una fabbrica;
- un micro data center;
- un nodo 5G/MEC;
- un dispositivo embedded;
- un cluster Kubernetes vicino alla sorgente dei dati.
L’edge è quindi soprattutto un modello architetturale, non un particolare tipo di hardware.
I protocolli più utilizzati
Ed è qui che la situazione diventa interessante.
Non esiste “il protocollo dell’Edge Computing”. L’edge mette insieme diversi livelli di comunicazione.
Possiamo avere protocolli per:
- dispositivi IoT;
- telemetria;
- sistemi industriali;
- API;
- comunicazione tra servizi;
- networking;
- sincronizzazione.
Tra quelli più importanti troviamo MQTT, CoAP, OPC UA, HTTP/HTTPS e, in determinati contesti, WebSocket e protocolli industriali specifici.
MQTT
MQTT è probabilmente uno dei protocolli più conosciuti nell’ecosistema IoT.
È basato sul modello:
Publisher
    |
    v
  Broker
    |
    +----> Subscriber
    |
    +----> Subscriber
    |
    +----> Subscriber
Un dispositivo pubblica un messaggio su un topic:
factory/machine1/temperaturee i client interessati a quel topic ricevono il dato.
Per esempio:
temperature = 72.4Il vantaggio è che producer e consumer non devono conoscersi direttamente.
Questo rende MQTT particolarmente interessante in ambienti con molti dispositivi e connessioni intermittenti.
Nelle architetture edge, un broker MQTT può vivere direttamente sull’edge node, permettendo di gestire localmente parte del traffico.
Per la sicurezza, MQTT viene normalmente utilizzato sopra TLS, con autenticazione e autorizzazione appropriate.
CoAP
CoAP (Constrained Application Protocol) nasce invece con un obiettivo diverso: comunicare con dispositivi estremamente limitati in termini di memoria, CPU, energia e banda.
È concettualmente vicino al modello REST/HTTP:
GET
POST
PUT
DELETE
ma è progettato per ambienti constrained e utilizza tipicamente UDP.
Un esempio concettuale:
GET coap://sensor/temperatureÈ particolarmente interessante nell’IoT embedded.
HTTP / HTTPS
Non dobbiamo dimenticare HTTP.
Molte applicazioni edge sono semplicemente applicazioni software che comunicano tramite API REST:
Edge Service
     |
     | HTTPS
     v
Cloud API
HTTPS offre la protezione del traffico tramite TLS.
È particolarmente naturale quando l’edge deve comunicare con API web, servizi cloud o microservizi.
WebSocket
Quando serve una comunicazione bidirezionale e persistente, può essere utile WebSocket.
Per esempio:
Edge
  ↕
Cloud
anziché effettuare continuamente richieste HTTP indipendenti.
È interessante per dashboard, streaming di eventi e applicazioni che richiedono aggiornamenti quasi real-time.
E la sicurezza?
Qui arriviamo probabilmente alla parte più importante.
L’Edge Computing presenta un problema particolare:
stiamo distribuendo capacità computazionale fuori dal data center centrale.
Nel cloud possiamo avere data center altamente controllati.
Un edge node potrebbe invece trovarsi:
- in una fabbrica;
- in un negozio;
- in una stazione;
- su una strada;
- in un veicolo;
- in un luogo fisicamente non controllato.
L’attack surface quindi aumenta.
NIST sottolinea proprio come cloud ed edge abbiano modificato e, in alcuni casi, aumentato significativamente la superficie d’attacco, rendendo importante proteggere anche la piattaforma hardware sulla quale vengono eseguiti workload e dati.
1. Autenticazione dei dispositivi
Il primo problema è:
“Come faccio a sapere che questo dispositivo è realmente quello che dice di essere?”
Non basta quindi:
username + passwordIn molti scenari si utilizzano certificati digitali e identità crittografiche dei dispositivi.
Possiamo avere:
Device
   |
   | certificate
   v
Edge
   |
   | certificate
   v
Cloud
Ogni componente possiede una propria identità.
2. Encryption
I dati devono essere protetti sia:
in transit
Device → Edge → Cloudsia, quando necessario:
at rest
Edge StoragePer esempio:
MQTT over TLS
HTTPS / TLS
VPN / secure tunnels
sono strumenti che possono contribuire a proteggere le comunicazioni.
3. Zero Trust
L’Edge si sposa molto bene con il paradigma Zero Trust.
Il principio fondamentale è:
non fidarti automaticamente di un dispositivo solo perché si trova “dentro la rete”.
Ogni accesso deve essere autenticato e autorizzato.
Concettualmente:
             ┌──────┐
            │ Edge Device│
            └──────┘
                    │
                     v
              Authentication
                    │
                     v
               Authorization
                    │
                     v
               Edge Service
NIST descrive Zero Trust proprio come un modello che elimina l’assunzione di fiducia implicita basata sulla posizione di rete e prevede verifiche continue e controlli di accesso basati sul rischio.
4. Least Privilege
Un dispositivo dovrebbe avere solo i permessi che gli servono.
Per esempio:
Temperature Sensor

READ:
  temperature

WRITE:
  niente

ACCESS:
  temperature-service
Non dovrebbe avere automaticamente accesso a:
database
admin API
other sensors
production controller
Questo limita enormemente il danno nel caso in cui il dispositivo venga compromesso.
5. Network Segmentation
In un ambiente industriale, non vorremmo avere:
Internet
   |
   +---- PLC
   +---- Camera
   +---- Database
   +---- Edge Server
   +---- Laptop
tutti sulla stessa rete.
È molto più sicuro creare segmenti:
                                       Firewall
                                              |
       ┌─────────┴─────────┐
        |                                                                          |
   IT Network                                                  OT Network
        |                                                                          |
    Servers                                                              PLCs
                                                                                   |
                                                                               Edge
e controllare esplicitamente quali comunicazioni sono consentite.
La microsegmentazione è infatti una delle tecniche considerate nelle architetture Zero Trust moderne.
6. Secure Boot e Hardware Security
C’è però un problema che nel cloud spesso sottovalutiamo:
l’edge node è un computer fisico.
Qualcuno potrebbe avere accesso fisico al dispositivo.
Per questo entrano in gioco tecnologie come:
- Secure Boot;
- TPM;
- Trusted Execution Environment;
- Secure Enclave;
- hardware-backed keys;
- HSM.
NIST considera queste tecnologie parte di un approccio multilivello alla sicurezza delle piattaforme cloud ed edge.
L’idea è creare una root of trust hardware.
In altre parole:
Hardware Root of Trust
          |
          v
     Secure Boot
          |
          v
   Trusted OS / Hypervisor
          |
          v
     Edge Runtime
          |
          v
      Application
La sicurezza quindi parte dal basso.
7. Aggiornamenti e gestione del ciclo di vita
Un altro enorme problema dell’Edge è che possiamo avere:
10 dispositivi
100 dispositivi
10.000 dispositivi
1.000.000 dispositivi
sparsi fisicamente in luoghi diversi.
Come aggiorniamo il software?
Serve una gestione centralizzata del ciclo di vita:
        Control Plane
             |
      ┌──────┼──────┐
      ↓      ↓      ↓
    Edge1  Edge2  Edge3
      ↓      ↓      ↓
    EdgeN  EdgeN  EdgeN
Gli aggiornamenti devono essere:
- autenticati;
- firmati;
- verificabili;
- possibilmente atomici;
- monitorabili;
- reversibili in caso di failure.
Un edge device non aggiornato può diventare un punto d’ingresso per l’intera infrastruttura.
8. Monitoring e detection
Non basta proteggere l’edge.
Bisogna anche sapere cosa sta succedendo.
Per esempio:
Edge
 |
 +--> logs
 |
 +--> metrics
 |
 +--> security events
 |
 +--> network telemetry
 |
 v
SIEM / Monitoring
Un comportamento anomalo può essere:
Normal:
Sensor → Edge → Cloud

Anomaly:
Sensor → Edge → Unknown IP
             → 5000 requests/sec
             → privilege escalation
L’osservabilità diventa quindi parte integrante della sicurezza.
Un’architettura Edge completa
Mettendo insieme tutti questi concetti possiamo immaginare:
                  CLOUD
        ┌─────────────────────┐
        │ Analytics           │
        │ Data Lake           │
        │ AI Training         │
        │ Central Management  │
        └──────────┬──────────┘
                   │
                 HTTPS
                   │
          ┌────────┴────────┐
          │                 │
       Edge 1            Edge 2
    ┌───────────┐      ┌───────────┐
    │ MQTT      │      │ MQTT      │
    │ OPC UA    │      │ OPC UA    │
    │ AI Model  │      │ AI Model  │
    │ Local DB  │      │ Local DB  │
    └─────┬─────┘      └─────┬─────┘
          │                   │
       Sensors             Sensors
       PLCs                 Cameras
       Machines             Devices
La sicurezza attraversa tutti i livelli:
Identity
   +
Encryption
   +
Least Privilege
   +
Segmentation
   +
Secure Boot
   +
Signed Updates
   +
Monitoring
   +
Zero Trust
La vera differenza rispetto al Cloud
Forse il modo più semplice per capire l’Edge Computing è questo.
Nel cloud abbiamo tradizionalmente:
DATA
 ↓
NETWORK
 ↓
COMPUTE
Nell’edge portiamo il compute verso il dato:
DATA
 ↓
COMPUTE
 ↓
NETWORK
 ↓
CLOUD
Questo cambia completamente le caratteristiche del sistema.
Riduciamo potenzialmente:
latency
bandwidth
dipendenza dalla connettività
e possiamo migliorare:
privacy
resilienza
reattività
Ma paghiamo un prezzo:
più nodi = più superficie d’attacco.
Ed è probabilmente questa la caratteristica più importante da ricordare.
L’Edge Computing non è semplicemente:
Cloud, ma più vicino all’utente.
È un paradigma nel quale computazione, dati, rete e sicurezza vengono distribuiti lungo tutta la catena che va dal dispositivo al cloud.
Ed è proprio questa distribuzione a renderlo potente… e allo stesso tempo molto più difficile da proteggere.