Se hai scritto codice in JavaScript, Python, Kotlin o persino in SQL negli ultimi anni, hai usato la programmazione funzionale senza nemmeno saperlo. Un tempo relegata ai laboratori di ricerca accademica, oggi la programmazione funzionale (FP) è il motore invisibile dietro alle architetture software più scalabili del pianeta e alla gestione dei Big Data.
In questo articolo esploreremo le origini di questo paradigma, analizzeremo il funzionamento interno delle sue funzioni chiave e vedremo come queste tecnologie permettono a giganti come Google e Netflix di elaborare petabyte di dati al secondo.
1. Le Origini: Prima dei Computer esisteva il Calcolo
Per capire la programmazione funzionale dobbiamo fare un salto indietro nel tempo, precisamente nel 1936. I computer commerciali non esistevano ancora, ma i matematici stavano già cercando di definire cosa fosse “computabile”.
Due menti brillanti affrontarono il problema da due angolazioni diverse:
- Alan Turing inventò la Macchina di Turing, un modello matematico basato su un nastro di memoria e uno stato che cambia nel tempo. Questo ha dato vita al paradigma imperativo (i cicli
for, l’assegnazione di variabili, il cambio di stato). - Alonzo Church creò il Lambda Calcolo , un sistema formale basato interamente sulla valutazione di funzioni matematiche pure, prive di stato e immutabili. Questo ha dato vita al paradigma funzionale.
Quando i computer divennero realtà, il modello di Turing vinse temporaneamente la sfida commerciale perché rispecchiava fedelmente l’hardware fisico (la CPU esegue istruzioni in sequenza, la RAM memorizza lo stato). Il primo linguaggio funzionale della storia, il LISP (sviluppato da John McCarthy nel 1958), rimase a lungo un ecosistema per specialisti.
Oggi, con l’avvento dei processori multicore e dei sistemi distribuiti nel cloud, il modello di Church sta vivendo una rinascita totale: l’assenza di uno stato condiviso rende il codice funzionale intrinsecamente sicuro per il calcolo parallelo.
2. La Classificazione delle Funzioni nel Mondo Funzionale
Spesso si fa confusione tra i vari termini della programmazione funzionale. Un blocco di codice non è semplicemente “una funzione”: in base al suo comportamento e alla sua struttura, rientra in categorie ben precise. La tassonomia non si ferma alle funzioni pure, ma segue una gerarchia fondamentale.
                  ┌───────────────────────────────┐
                  │           FUNZIONE            │
                  └───────────────┬───────────────┘
          ┌───────────────────────┴───────────────────────┐
          ▼                                               ▼
┌───────────────────┐                           ┌───────────────────┐
│     Esecuzione    │                           │    Firma/Tipo     │
│ (Pure vs Impure)  │                           │  (Ordine / Grado) │
└───────────────────┘                           └───────────────────┘
Funzioni Pure vs Funzioni Impure (Criterio di Esecuzione)
Questa distinzione guarda a come la funzione interagisce con il resto del mondo.
- Funzione Pura: Riceve dati, elabora dati, restituisce dati. Fine. Se invocata cento volte con lo stesso input, darà sempre lo stesso output (trasparenza referenziale) e non genera side effects (non tocca variabili globali, file, database o log hardware).
- Funzione Impura: Interagisce con lo stato esterno. Può dipendere da variabili che cambiano (es. l’orario di sistema o un valore dinamico nel database) o modificare l’ambiente (es. scrivere un file o alterare una variabile globale).
Funzioni di Primo Ordine vs Funzioni di Ordine Superiore / Alto Grado (Criterio Strutturale)
Questa distinzione guarda a cosa la funzione accetta come input o restituisce come output nella sua firma.
- Funzione di Primo Ordine (First-Order): Accetta come argomenti solo valori primitivi o oggetti (numeri, stringhe, array) e restituisce valori primitivi o oggetti. È la classica funzione standard.
- Funzione di Ordine Superiore (Higher-Order / Alto Grado): Tratta le funzioni come “cittadini di prima classe” (First-Class Citizens). Significa che la funzione fa almeno una di queste due cose:
- Accetta un’altra funzione come parametro (es. i metodi
mapofilter). - Restituisce una nuova funzione come risultato (tecnica alla base di pattern avanzati come il Currying o le Closure).
- Accetta un’altra funzione come parametro (es. i metodi
Nota di scomposizione concettuale: Una funzione può essere sia Pura che di Ordine Superiore allo stesso tempo. Ad esempio, il metodo
mapnativo di JavaScript è una funzione di ordine superiore (perché accetta una funzione di callback) ed è pura (perché non modifica l’array originale ma ne crea uno nuovo).
Altre Classificazioni Importanti da Conoscere
Per completare l’atlante delle funzioni nella FP, incontriamo altri tre tipi fondamentali:
- Funzioni Anonime (Lambda): Funzioni prive di nome, spesso dichiarate al volo per essere passate come argomento a una funzione di ordine superiore (es.
x => x * 2). - Funzioni Ricorsive: Funzioni che richiamano se stesse all’interno del proprio corpo. Sostituiscono i tradizionali cicli imperativi (
for/while) per scorrere le strutture dati. - Funzioni Composte (Composition): Funzioni nate dall’unione di due o più funzioni separate, dove l’output della prima diventa l’input della seconda:
(h(x) = f(g(x))).
Focus Avanzato: I Superpoteri delle Funzioni di Ordine Superiore – Closure e Currying
Quando una funzione è in grado di accettare o restituire altre funzioni, sblocca due pattern architetturali che stravolgono il modo in cui gestiamo lo stato e configuriamo il codice: le Closure e il Currying.
1. Le Closure (Chiusure)
Una Closure si verifica quando una funzione interna “si ricorda” e ha accesso alle variabili del suo perimetro esterno (lo scope in cui è stata creata), anche dopo che la funzione esterna ha terminato la sua esecuzione.
- A cosa serve: Permette di incapsulare i dati e creare variabili “private” senza usare le classi della programmazione orientata agli oggetti (OOP).
- Sotto il cofano: Il linguaggio mantiene in memoria l’ambiente in cui la funzione è nata.
javascript
function creaContatore() {
  let conteggio = 0; // Questa variabile è protetta e inaccessibile dall'esterno

  return function() {
    conteggio++; // La funzione interna ha creato una closure su 'conteggio'
    return conteggio;
  };
}

const mioContatore = creaContatore();
console.log(mioContatore()); // 1
console.log(mioContatore()); // 2
// Non c'è modo di modificare direttamente la variabile 'conteggio' se non invocando la closure.
2. Il Currying (Currizzazione)
Prende il nome dal matematico Haskell Curry. È una tecnica geometrico-matematica che consiste nel trasformare una funzione che accetta più argomenti contemporaneamente (es. f(a, b, c)) in una serie di funzioni concatenate che accettano un solo argomento alla volta (es. f(a)(b)(c)).
- A cosa serve: Permette la valutazione parziale o configurazione progressiva delle funzioni. Puoi passare i primi parametri stabili e generare una nuova funzione specializzata pronta a ricevere gli argomenti finali in un secondo momento.
- Esempio reale: Creare un sistema di logging flessibile.
javascript
// Funzione standard non currizzata
const logStandard = (livello, messaggio) => `[${livello}] ${messaggio}`;

// Stessa funzione trasformata tramite Currying
const logCurrizzato = livello => messaggio => `[${livello}] ${messaggio}`;

// Configurazione parziale: creiamo funzioni specifiche riutilizzabili
const logErrore = logCurrizzato("ERROR");
const logInfo = logCurrizzato("INFO");

// Utilizzo pratico nel codice
console.log(logErrore("Connessione al database fallita")); // "[ERROR] Connessione al database fallita"
console.log(logInfo("Applicazione avviata correttamente")); // "[INFO] Applicazione avviata correttamente"
Grazie alle closure che mantengono memorizzato il parametro "ERROR", il Currying ti consente di “fissare” dei pezzi di logica e generare codice componibile, pulito e privo di ripetizioni.
3. Esempi Pratici di Codice (in JavaScript)
Vediamo la differenza pratica tra l’approccio classico (imperativo/impuro) e quello moderno (funzionale/puro) con due casi concreti che affronti ogni giorno nello sviluppo.
Caso 1: Filtrare e calcolare il totale di un carrello
Immaginiamo di voler calcolare il totale speso ma solo per i prodotti elettronici.
Approccio Imperativo (Uso di cicli e mutazione di stato)
javascript
// Stato iniziale
const carrello = [
  { prodotto: "Laptop", categoria: "elettronica", prezzo: 1000 },
  { prodotto: "Libro", categoria: "libri", prezzo: 20 },
  { prodotto: "Smartphone", categoria: "elettronica", prezzo: 500 }
];

let totaleSpeso = 0; // Variabile accumulatore mutabile

for (let i = 0; i < carrello.length; i++) {
  if (carrello[i].categoria === "elettronica") {
    totaleSpeso += carrello[i].prezzo; // Mutazione di stato continua
  }
}
console.log(totaleSpeso); // 1500
Approccio Funzionale (Combinazione di funzioni di ordine superiore pure)
javascript
const carrello = [
  { prodotto: "Laptop", categoria: "elettronica", prezzo: 1000 },
  { prodotto: "Libro", categoria: "libri", prezzo: 20 },
  { prodotto: "Smartphone", categoria: "elettronica", prezzo: 500 }
];

// Componiamo una pipeline dichiarativa e leggibile
const totaleElettronica = carrello
  .filter(item => item.categoria === "elettronica") // Filtra (Funzione Ordine Superiore)
  .map(item => item.prezzo)                         // Estrae i prezzi (Funzione Ordine Superiore)
  .reduce((acc, prezzo) => acc + prezzo, 0);       // Aggrega (Reduce/Fold con valore iniziale 0)

console.log(totaleElettronica); // 1500
// Il carrello originale è rimasto intatto e immutato!
Caso 2: Creare una funzione di ordine superiore personalizzata
Vediamo come generare codice dinamico sfruttando una funzione che restituisce un’altra funzione.
javascript
// Funzione di Ordine Superiore (Pura) che genera "moltiplicatori"
function creaMoltiplicatore(fattore) {
  return function(numero) { // Restituisce una nuova funzione
    return numero * fattore;
  };
}

// Generiamo funzioni specifiche al volo
const raddoppia = creaMoltiplicatore(2);
const triplica = creaMoltiplicatore(3);

console.log(raddoppia(5)); // 10
console.log(triplica(5));  // 15
4. Cheat Sheet Definitivo: I Mattoncini della FP
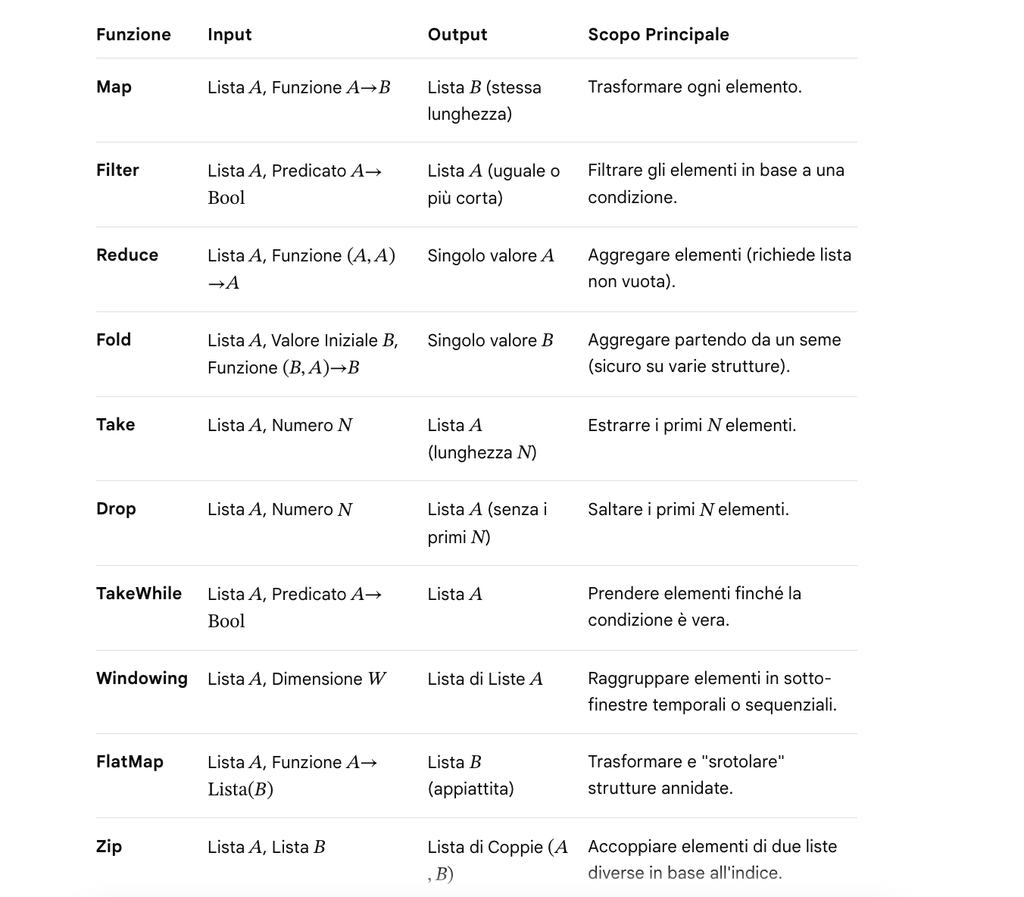
Nel paradigma funzionale non si dice al computer come fare qualcosa, ma cosa si vuole ottenere. Per farlo, utilizziamo dei combinatori standardizzati.
Ecco una tabella di riferimento rapida per le funzioni più utilizzate:
5. Sotto il Cofano di MapReduce: Il Motore dei Big Data
Quando i dati superano la capacità di archiviazione ed elaborazione di un singolo server, siamo nel territorio dei Big Data. All’inizio degli anni 2000, Google ha formalizzato un framework software per risolvere questo problema, ispirandosi direttamente al paradigma funzionale: MapReduce.
Ma come funziona esattamente sotto il cofano quando dobbiamo elaborare un file di testo da 10 Terabyte distribuito su 1.000 server? Il processo si divide in tre fasi logiche cruciali:
1. La Fase di Map (Trasformazione Parallela)
Il sistema distribuisce i dati grezzi su centinaia di nodi (server). Ogni nodo esegue una funzione Mappura localmente sui propri frammenti di dati.
- Caratteristica chiave: Poiché la funzione è pura e non dipende da elementi esterni, i 1.000 server possono lavorare contemporaneamente senza mai parlarsi, azzerando i colli di bottiglia della rete.
- Output: Ogni mappa produce una serie di coppie Chiave-Valore temporanee:
(chiave, valore).
2. La Fase Intermedia: Shuffle & Sort (Il Raggruppamento)
Il framework (es. Hadoop o Spark) prende l’output di tutti i Map e ridistribuisce i dati attraverso la rete in modo che tutte le chiavi identiche finiscano sullo stesso server. Se la chiave è "punti_vendita_roma", tutti i record associati a Roma verranno convogliati verso un unico nodo dedicato.
3. La Fase di Reduce (Aggregazione)
Ora che un singolo server ha tutti i dati associati a una specifica chiave, viene applicata la funzione Reduce.
- La funzione prende la lista di valori legati a quella chiave e li aggrega in un unico risultato finale (es. calcola la somma dei ricavi di quel punto vendita).
- Poiché l’operazione di Reduce soddisfa la proprietà associativa, il framework può persino eseguire calcoli parziali sui nodi di partenza prima dello shuffle (operazione nota come Combiner), risparmiando banda di rete.
6. Oltre MapReduce: Le Funzioni Funzionali nei Moderni Strumenti di Streaming
MapReduce nasceva per l’elaborazione “Batch” (offline, un blocco di dati alla volta). Oggi i Big Data richiedono analisi in tempo reale (Streaming). Framework moderni come Apache Spark, Apache Flink e Apache Kafka utilizzano varianti ancora più spinte dei concetti funzionali:
Windowing e Serie Temporali
Nello streaming di dati (es. i tweet globali o le transazioni con carta di credito), i dati non finiscono mai. Non puoi fare un Reduce su una lista infinita.
Qui entra in gioco il Windowing: i dati vengono tagliati in finestre temporali artificiali (es. “ogni 10 secondi”) e la funzione di aggregazione (Fold o Reduce) viene applicata solo all’interno di quella finestra.
Perché i Big Data amano l’Immutabilità?
In informatica, il problema più grande del calcolo parallelo sono i conflitti di memoria (due processori che modificano la stessa variabile nello stesso momento).
La programmazione funzionale risolve il problema alla radice: i dati sono immutabili. Una volta creato un record di un log, questo non viene mai modificato. Se serve una modifica, si applica una Map che genera un nuovo flusso di dati. Niente conflitti, niente blocchi hardware, scalabilità lineare infinita.
Conclusioni
Il passaggio dal codice imperativo tradizionale ai pattern funzionali non è solo una scelta stilistica, è una necessità architettural-strutturale. Dominare concetti come le funzioni pure, saper scegliere tra un Fold e un Reduce e comprendere la classificazione dei blocchi di codice ti permetterà di progettare software elegante, privo di bug latenti e strutturalmente pronto per l’era del cloud computing.